


Entkopplung der Unternehmens-Geschäftslogik: Architektur eines cloud-nativen ERP-Backends mit Clean Architecture
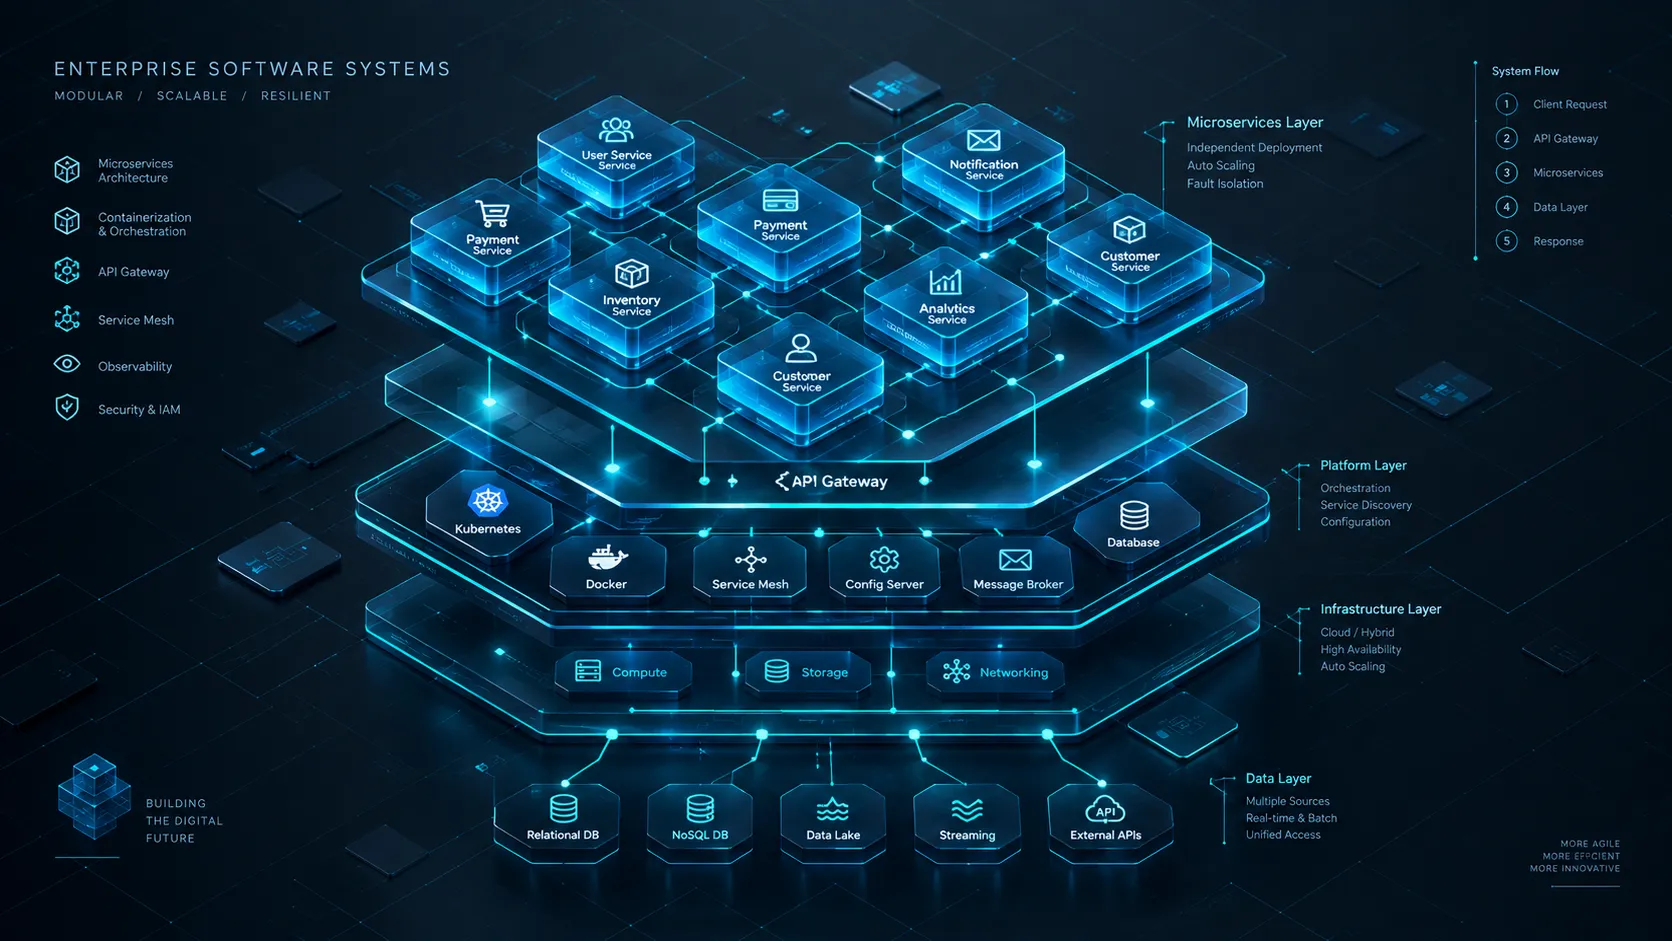
Ein praktischer Engineering-Leitfaden für die Entwicklung missionskritischer ERP-Backends — wo Buchhaltung, Lagerverwaltung und abteilungsübergreifende Transaktionen unter hoher Nebenläufigkeit korrekt bleiben müssen und technische Schulden keine Option sind.
Einführung — Das ERP-Paradoxon
Enterprise-Resource-Planning-Systeme stehen im Zentrum der operativen Realität jedes großen Unternehmens. Sie verarbeiten Finanztransaktionen, verwalten physische Bestände, koordinieren Lieferketten und erzwingen Compliance. Sie sind per Definition missionskritisch.
Dennoch sind die meisten ERP-Systeme architektonische Paradoxien:
Sie müssen sich entwickeln — Geschäftsregeln ändern sich ständig
Sie müssen stabil bleiben — Ausfallzeiten kosten echtes Geld
Sie müssen skalieren — Transaktionsvolumen wächst unaufhörlich
Sie müssen auditierbar sein — Regulierungsbehörden und Wirtschaftsprüfer fordern Nachverfolgbarkeit
Die traditionelle Antwort waren monolithische Architekturen mit eng gekoppelten Modulen. Das funktioniert — bis es nicht mehr funktioniert. Eine Änderung in der Abrechnungslogik bricht die Lagerberichterstattung. Ein Datenbankschema-Update destabilisiert das Hauptbuch. Ein neues Feature führt technische Schulden ein, die sich über Jahre summieren.
Dieser Artikel behandelt einen anderen Ansatz:
Architektur von ERP-Backends mit strikten Domänengrenzen, Clean-Architecture-Prinzipien und Datenbankdesigns, die für hochlastige Transaktionsverarbeitung entwickelt wurden.
Das Ziel ist nicht theoretische Eleganz. Das Ziel ist Skalierbarkeit im Betrieb — ein System, das sich weiterentwickeln kann, ohne zu brechen, und unter Last performt, ohne die Korrektheit zu kompromittieren.
Teil 1 — Warum Clean Architecture für ERP nicht verhandelbar ist
Clean Architecture, wie von Robert C. Martin formuliert, etabliert ein grundlegendes Prinzip:
Abhängigkeiten zeigen nach innen. Die Domäne weiß nichts über die Infrastruktur.
Für ERP-Systeme ist dies keine akademische Reinheit — es ist eine Überlebensanforderung.
Die geschichtete Struktur
┌─────────────────────────────────────────────────────────────────┐
│                    PRÄSENTATIONS-EBENE                          │
│              (API-Controller, GraphQL, UI)                      │
├─────────────────────────────────────────────────────────────────┤
│                    ANWENDUNGS-EBENE                             │
│     (Use Cases, CQRS-Handler, DTOs, Validierung)                │
├─────────────────────────────────────────────────────────────────┤
│                      DOMÄNEN-EBENE                              │
│    (Entities, Value Objects, Domain Services, Events)           │
│                 — KEINE EXTERNEN ABHÄNGIGKEITEN —               │
├─────────────────────────────────────────────────────────────────┤
│                  INFRASTRUKTUR-EBENE                            │
│       (Persistenz, externe APIs, Messaging, Cache)              │
└─────────────────────────────────────────────────────────────────┘
Die Abhängigkeitsrichtung ist strikt nach innen. Die Domänen-Ebene definiert Interfaces; die Infrastruktur implementiert sie.
Warum das speziell für ERP wichtig ist
| Anliegen | Monolithisches ERP | Clean-Architecture-ERP |
|---|---|---|
| Änderungen der Geschäftsregeln | Auswirkungen über die gesamte Codebasis | Isoliert auf die Domänen-Ebene |
| Datenbankmigration | Erfordert Berührung der Geschäftslogik | Nur Infrastruktur-Austausch |
| Testing | Erfordert vollständiges Stack-Setup | Domänen-Logik isoliert testbar |
| Framework-Upgrades | Hohes Risiko, querschnittlich | Auf äußere Ebenen begrenzt |
| Neue Teammitglieder | Müssen alles verstehen | Können Ebene für Ebene arbeiten |
Die Änderungskosten sind umgekehrt proportional zur Stärke Ihrer Grenzen.
Die Lösungsstruktur (konkret)
Basierend auf produktionsreifen Clean-Architecture-ERP-Implementierungen:
src/
├── Presentation/
│   └── ERP.API                    # Web-API-Endpunkte
├── CompositionRoot/
│   └── ERP.CompositionRoot        # Abhängigkeitsverdrahtung
├── Core/
│   ├── ERP.Domain                 # Entities + Verträge (KEINE Abhängigkeiten)
│   ├── ERP.Application            # Use Cases, Handler, DTOs
│   └── ERP.Shared                 # Gemeinsame Primitive
└── Infrastructure/
    ├── ERP.Infrastructure         # Externe Service-Integrationen
    └── ERP.Persistence            # Datenbankzugriff
Kernregel: Das API-Projekt referenziert niemals direkt Infrastruktur-Typen. Die gesamte Verdrahtung erfolgt im Composition Root.
Teil 2 — Domain-Driven Design: Bounded Contexts für ERP
ERP-Systeme zerlegen sich natürlich in Bounded Contexts — jeder mit seiner eigenen Ubiquitous Language, seinem eigenen Modell und seinen eigenen Regeln.
Die 8 Tier-1-ERP-Domänen
Ein gut architektiertes ERP-System trennt den globalen Zustand in isolierte Ausführungsumgebungen:
| Domäne | Verantwortung |
|---|---|
| Finanzen | Hauptbuch, AP/AR, unveränderliches doppeltes Buchführungssystem |
| Lieferkette | Physischer Bestand, SKU-Verfolgung, Beschaffung |
| Umsatz | Verkaufsaufträge, Kundenbeziehungs-Mapping |
| Humankapital | Mitarbeiterdaten, Gehaltsabrechnung, Rollen |
| Unternehmensanlagen | Infrastruktur, Lagerverwaltung |
| Recht | Compliance, Audit-Logs (SOC2/SOX) |
| Lernen | Zertifizierungen, Schulungskonformität |
| Stammdaten | Der „Golden Record” — universelle ID-Übersetzung |
Der Goldene Faden: Domänenübergreifende Kommunikation ohne SQL-Fremdschlüssel
Traditionelle ERP-Systeme verwenden Fremdschlüssel auf Datenbankebene, um referenzielle Integrität über Domänen hinweg aufrechtzuerhalten. Dies erzeugt enge Kopplung auf der Datenschicht — die schädlichste Form technischer Schulden in ERP-Systemen.
Die architektonische Alternative: Der Goldene Faden:
Traditioneller Ansatz:
  SalesOrder.customer_id → FOREIGN KEY → Customer.id
  → Datenbank-erzwungene Kopplung
  → Domänen können nicht unabhängig skalieren
  → Schema-Änderungen propagieren über Domänen

Goldener-Faden-Ansatz:
  SalesOrder.customer_uuid: uuid.UUID  (anwendungsverwalteter Zeiger)
  → Kein Datenbank-Level-FK zwischen Domänen
  → Jede Domäne besitzt ihre Tabellen exklusiv
  → Domänen skalieren horizontal und unabhängig
Engineering-Begründung: Fremdschlüssel erzeugen implizite Kopplung. In einem Hochlast-System löst ein Bulk-Delete auf einer Parent-Tabelle Constraint-Prüfungen über alle referenzierenden Tabellen aus — eine Performance-Katastrophe im Maßstab.
Wenn ein Kunde mit 500.000 Bestellungen gelöscht wird, muss die Datenbank jede Fremdschlüsselreferenz validieren. Deshalb berichten Produktions-ERP-Systeme von Bulk-Deletes mit 120+ Minuten und 280GB temporären Dateien.
Verteilte Transaktionen: Das Saga-Muster
Ohne ACID-Transaktionen auf Datenbankebene über Domänen hinweg — wie erhalten wir Konsistenz?
Temporale Sagas — verteilte Workflows mit kompensierenden Aktionen:
Szenario: Auftragszuweisung über Lieferkette und Finanzen

┌─────────────────────────────────────────────────────────────┐
│                    AUFTRAGS-SAGA-WORKFLOW                   │
├─────────────────────────────────────────────────────────────┤
│  1. ReserveInventoryActivity (SCM-Domäne)                   │
│     └─ ERFOLG → weiter zu Schritt 2                         │
│     └─ FEHLER → kompensieren, abbrechen                     │
│                                                             │
│  2. LockLedgerActivity (Finanz-Domäne)                      │
│     └─ ERFOLG → weiter zu Schritt 3                         │
│     └─ FEHLER → ReverseInventoryActivity auslösen           │
│                                                             │
│  3. ConfirmOrderActivity (Umsatz-Domäne)                    │
│     └─ ERFOLG → Saga abgeschlossen                          │
│     └─ FEHLER → alle vorherigen Schritte kompensieren       │
└─────────────────────────────────────────────────────────────┘
Dieses Muster garantiert Eventual Consistency ohne Phantom-Locks oder verteilte Deadlocks.
Teil 3 — PostgreSQL für hochlastiges ERP: Die Engineering-Details
PostgreSQL ist die Datenbank der Wahl für die meisten modernen ERP-Systeme. Aber Standardkonfigurationen reichen für hochlastige Transaktionsverarbeitung nicht aus.
Die Fremdschlüssel-Indexierungs-Falle
Dies ist das häufigste Performance-Versäumnis im ERP-Datenbankdesign.
Die Tatsache: PostgreSQL erstellt automatisch einen Index auf der referenzierten Seite eines Fremdschlüssels (dem Primary Key der Parent-Tabelle). Es erstellt nicht automatisch einen Index auf der referenzierenden Seite (der Fremdschlüsselspalte selbst):
Tabellen:
  orders (id PRIMARY KEY, customer_id BIGINT, ...)
  customers (id PRIMARY KEY, ...)

PostgreSQL erstellt automatisch:
  INDEX ON customers(id)  ← bereits der PK, also No-Op

PostgreSQL erstellt NICHT:
  INDEX ON orders(customer_id)  ← IHRE VERANTWORTUNG
Konsequenz: Abfragen, die auf orders.customer_id filtern oder joinen, führen vollständige Tabellenscans durch. Cascading-Deletes und Fremdschlüssel-Constraint-Prüfungen scannen ebenfalls die gesamte Tabelle.
Realweltliche Auswirkung aus einer Produktions-ERP-Workload:
| Metrik | Vor Indexierung | Nach Indexierung |
|---|---|---|
| Bulk-Delete-Zeit | 120+ Minuten | ~62 Minuten |
| Generierung temporärer Dateien | 280 GB/Tag | 192,9 GB/Tag |
| Read-IOPS-Spitzen | 10-15 mal/Tag | 5-7 mal/Tag |
Index-Scans auf account_payment | — | 906.000+ im Beobachtungsfenster |
Die Lösung: Jede Fremdschlüsselspalte auditieren. Wenn sie in WHERE-Klauseln, JOINs oder Cascading-Operationen verwendet wird, indexieren Sie sie.
Indexierungsstrategie für ERP-Workloads
ERP-Datenbanken haben unterschiedliche Zugriffsmuster:
| Abfragemuster | Index-Strategie |
|---|---|
| Zeitbereichsberichte (Hauptbuch, Transaktionen) | Composite-Index auf (entity_id, transaction_date) |
| Status-basierte Filterung (ausstehende Aufträge, aktiver Bestand) | Partielle Indizes auf Status-Spalten |
| Point-Lookups (nach ID, nach Code) | Primary Key oder Unique Index |
| Domänenübergreifende Joins | Indexierte Fremdschlüsselspalten |
| Aggregat-Berichte | Covering-Indizes, wo machbar |
Kritische Erkenntnis: Indizes sind nicht kostenlos. Jeder Index fügt Schreib-Overhead hinzu. Für hochtransaktionale ERP-Systeme muss das Kosten-Nutzen-Verhältnis gemessen, nicht angenommen werden.
Monitoring und Wartung
Hochtransaktionale Datenbanken akkumulieren Bloat — tote Tupel aus Updates und Deletes.
Wesentliche Wartung für ERP-PostgreSQL:
-- Regelmäßiges VACUUM und ANALYZE
VACUUM ANALYZE orders;
VACUUM ANALYZE gl_entries;

-- Bloat überwachen
SELECT schemaname, tablename,
       pg_size_pretty(pg_total_relation_size(schemaname||'.'||tablename)) as total_size,
       n_dead_tup
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC;

-- Ungenutzte Indizes identifizieren
SELECT indexrelname, idx_scan, idx_tup_read
FROM pg_stat_user_indexes
WHERE idx_scan = 0
AND indexrelname NOT LIKE '%_pkey';
Wartungsphilosophie: Index-Optimierung ist keine einmalige Aktivität. Sie ist eine kontinuierliche operative Verantwortung.
Teil 4 — CQRS und die Read/Write-Trennung
ERP-Systeme haben grundlegend konfliktäre Zugriffsmuster:
Schreibpfad: Hochgradig normalisiert, transaktional korrekt, ACID-konform
Lesepfad: Denormalisiert, aggregiert, für Berichterstattung optimiert
CQRS (Command Query Responsibility Segregation) adressiert dies.
Das CQRS-Muster in ERP
┌─────────────────────────────────────────────────────────────────┐
│                        COMMAND-SEITE                            │
│  (Schreiboperationen: CreateOrder, PostJournalEntry, AdjustStock)│
│                                                                 │
│  Domänen-Modell → Geschäftsregeln → Event Store / Write DB      │
│                                                                 │
│  Eigenschaften:                                                 │
│  - Vollständige Domänen-Logik-Validierung                       │
│  - Transaktionale Konsistenz                                    │
│  - Normalisiertes Schema                                        │
│  - Event-Emission für nachgelagerte Consumer                    │
└─────────────────────────────────────────────────────────────────┘
                              │
                              │ Domain Events
                              ▼
┌─────────────────────────────────────────────────────────────────┐
│                         QUERY-SEITE                             │
│     (Leseoperationen: Berichte, Dashboards, Suche)              │
│                                                                 │
│  Read Models → Optimierte Views → Query DB / Cache              │
│                                                                 │
│  Eigenschaften:                                                 │
│  - Denormalisiert für schnelle Reads                            │
│  - Eventual Consistent                                          │
│  - Optimiert für spezifische Abfragemuster                      │
│  - Kann verschiedene Storage Engines nutzen                     │
└─────────────────────────────────────────────────────────────────┘
Warum das für ERP wichtig ist
Finanzberichte erfordern die Aggregation von Millionen von Transaktionen. Diese Abfragen gegen die transaktionale Datenbank auszuführen, erzeugt Lock-Contention, die neue Transaktionen blockiert.
CQRS ermöglicht:
Isolation: Berichtsabfragen blockieren niemals transaktionale Schreibvorgänge
Optimierung: Jede Seite nutzt das richtige Datenmodell für ihren Workload
Skalierbarkeit: Read-Replicas können unabhängig skalieren
Teil 5 — Vermeidung technischer Schulden in Hochlast-Systemen
Technische Schulden in ERP-Systemen sind einzigartig gefährlich, weil sie sich über jede Transaktion, jeden Bericht und jeden Integrationspunkt summieren.
Das Edge-Case-Anti-Pattern
Die häufigste Quelle von ERP-technischen Schulden: das Design für jede mögliche Ausnahme.
„Weniger als 5 % der Szenarien trieben über 50 % der Design-Komplexität. Die Mehrheit der Transaktionen berührte diese Pfade nie. Aber jede Transaktion trug das Gewicht dieses Designs.”
Die Lösung: Für den gemeinsamen Pfad entwerfen. Seltene Szenarien isolieren. Die Minderheit menschliches Eingreifen erfordern lassen.
FALSCHER ANSATZ:                  RICHTIGER ANSATZ:
─────────────────────────────     ─────────────────────────────
Jede Transaktion durchläuft       Gemeinsamer Pfad: optimierter
vollständige Validierung          automatisierter Workflow
aller Edge Cases
                                  Seltene Szenarien: für
Ergebnis:                         menschliche Überprüfung markiert
- 50 % des Codes handhaben
  5 % der Transaktionen           Ergebnis:
- Jede Transaktion zahlt die      - 95 % der Transaktionen schnell
  Performance-Kosten              - Edge Cases korrekt behandelt
- Testing-Komplexität explodiert  - Wartbare Codebasis
- Änderung wird gefährlich
Das Clean-Core-Prinzip
Für ERP-Systeme, die mit externen Plattformen (CRMs, E-Commerce, BTP-Erweiterungen) integrieren:
Den Kern sauber halten. Erweiterungen außerhalb bauen. Events für Kommunikation nutzen.
| Prinzip | Implementierung |
|---|---|
| Keine Kern-Modifikationen | Nur Extension Points |
| Keine direkten Schreibvorgänge in den Kern | API-vermittelte Kommunikation |
| Event-getriebene Integration | Async, lose gekoppelt |
| Klares Daten-Eigentum | System of Record pro Domäne definiert |
Dies verhindert das „Shadow-ERP”-Problem — wo Erweiterungen so eng gekoppelt werden, dass sie effektiv den Kern ersetzen und Upgrade-Alpträume erzeugen.
Teil 6 — Architektur in der Praxis: Request-Flow
Verständnis, wie eine Anfrage durch die Clean-Architecture-ERP-Ebenen fließt.
Query-Flow (Leseoperation)
GET /api/finance/journal-entries?dateFrom=2025-01-01

1. API-Controller empfängt Anfrage
   └─ Baut GetJournalEntriesQuery

2. Controller sendet Query via MediatR
   └─ IMediator.Send(query)

3. Application-Handler führt aus:
   ├─ Nutzt IJournalEntryRepository (Interface aus Domain)
   ├─ Wendet Filterung und Paginierung an
   ├─ Mappt Entities zu DTOs
   └─ Gibt Result<PagedResult<JournalEntryDto>> zurück

4. Controller konvertiert Result<T> zu API-Response
Command-Flow (Schreiboperation)
POST /api/finance/journal-entries

1. API-Controller empfängt Anfrage
   └─ Baut CreateJournalEntryCommand

2. Controller sendet Command via MediatR
   └─ IMediator.Send(command)

3. Application-Handler führt aus:
   ├─ Validiert Geschäfts-Constraints
   ├─ Erstellt Domänen-Entity via JournalEntry.Create(...)
   ├─ Speichert mit Repository + Unit of Work
   └─ Gibt Result<JournalEntryDto> zurück

4. Controller emittiert 201 Created
Querschnittliche Anliegen (MediatR-Pipeline)
Produktions-Clean-Architecture-ERP-Systeme registrieren Pipeline-Behaviors in strikter Reihenfolge:
1. LoggingBehavior        → Request/Response erfassen
2. PerformanceBehavior    → Ausführungszeit messen
3. ValidationBehavior     → FluentValidation-Regeln
4. CachingBehavior        → Für Queries, die ICacheableRequest implementieren
5. AuditingBehavior       → Wer tat was, wann
6. NotificationBehavior   → Domain-Event-Dispatch
7. RetryBehavior          → Transiente Fehler-Resilienz
Warum die Reihenfolge wichtig ist: Validierung muss vor Caching laufen (ungültige Anfragen nicht cachen). Auditing muss nach Validierung laufen (nur gültige Operationen auditieren).
Teil 7 — Wann diese Architektur verwendet werden sollte (und wann nicht)
Clean Architecture + DDD für ERP verwenden, wenn:
✅ Geschäftsregeln komplex sind und sich häufig ändern
✅ Mehrere Teams am selben System arbeiten
✅ Das System mit vielen externen Plattformen integriert
✅ Langfristige Wartbarkeit Priorität hat
✅ Transaktionskorrektheit nicht verhandelbar ist
✅ Die Domäne klare Bounded Contexts hat
NICHT verwenden, wenn:
❌ Die Anwendung ein einfaches CRUD-Interface ist
❌ Dem Team Erfahrung mit Domänenmodellierung fehlt
❌ Time-to-Market die langfristige Struktur überwiegt
❌ Die Domäne nicht komplex genug ist, um die Ebenen zu rechtfertigen
Clean Architecture ist eine Investition. Sie zahlt Erträge in Wartbarkeit und Skalierbarkeit. Sie kostet in anfänglicher Komplexität. Die Frage ist, ob Ihr ERP-System lange genug lebt, um die Erträge einzusammeln.
Fazit — ERP als Engineering-Disziplin
ERP-Systeme sind keine „Business-Software”. Sie sind verteilte Systeme mit finanziellen Konsequenzen.
Die zu Beginn getroffenen Architekturentscheidungen — wie Domänen abgegrenzt werden, wie Daten fließen, wie Konsistenz aufrechterhalten wird, wie Indizes entworfen werden — bestimmen, ob das System:
Skaliert mit Transaktionsvolumen oder unter Last kollabiert
Sich entwickelt mit Geschäftsanforderungen oder Veränderung widersteht
Korrekt bleibt unter Nebenläufigkeit oder still Daten korrumpiert
Betreibbar über Jahre ist oder Schulden akkumuliert, bis Ersatz die einzige Option ist
Clean Architecture, Domain-Driven Design und PostgreSQL-Engineering sind keine Schlagworte. Sie sind Disziplinen — jede adressiert einen spezifischen Fehlermodus von Unternehmenssystemen.
Das Ziel ist nicht perfekte Architektur. Das Ziel ist Architektur, die dem Unternehmen ermöglicht, zu operieren, zu skalieren und sich zu entwickeln — ohne dass das System zum Engpass wird.
Hinweis des Autors
Dieser Artikel spiegelt architektonische Muster wider, die bei der Entwicklung von CoreBiz ERP — einer modularen Unternehmensplattform für Buchhaltung, Lagerverwaltung und abteilungsübergreifende Transaktionen — entwickelt wurden. Für die Zusammenarbeit an Enterprise-ERP-Architektur erreichen Sie mich über die Kontaktseite.