


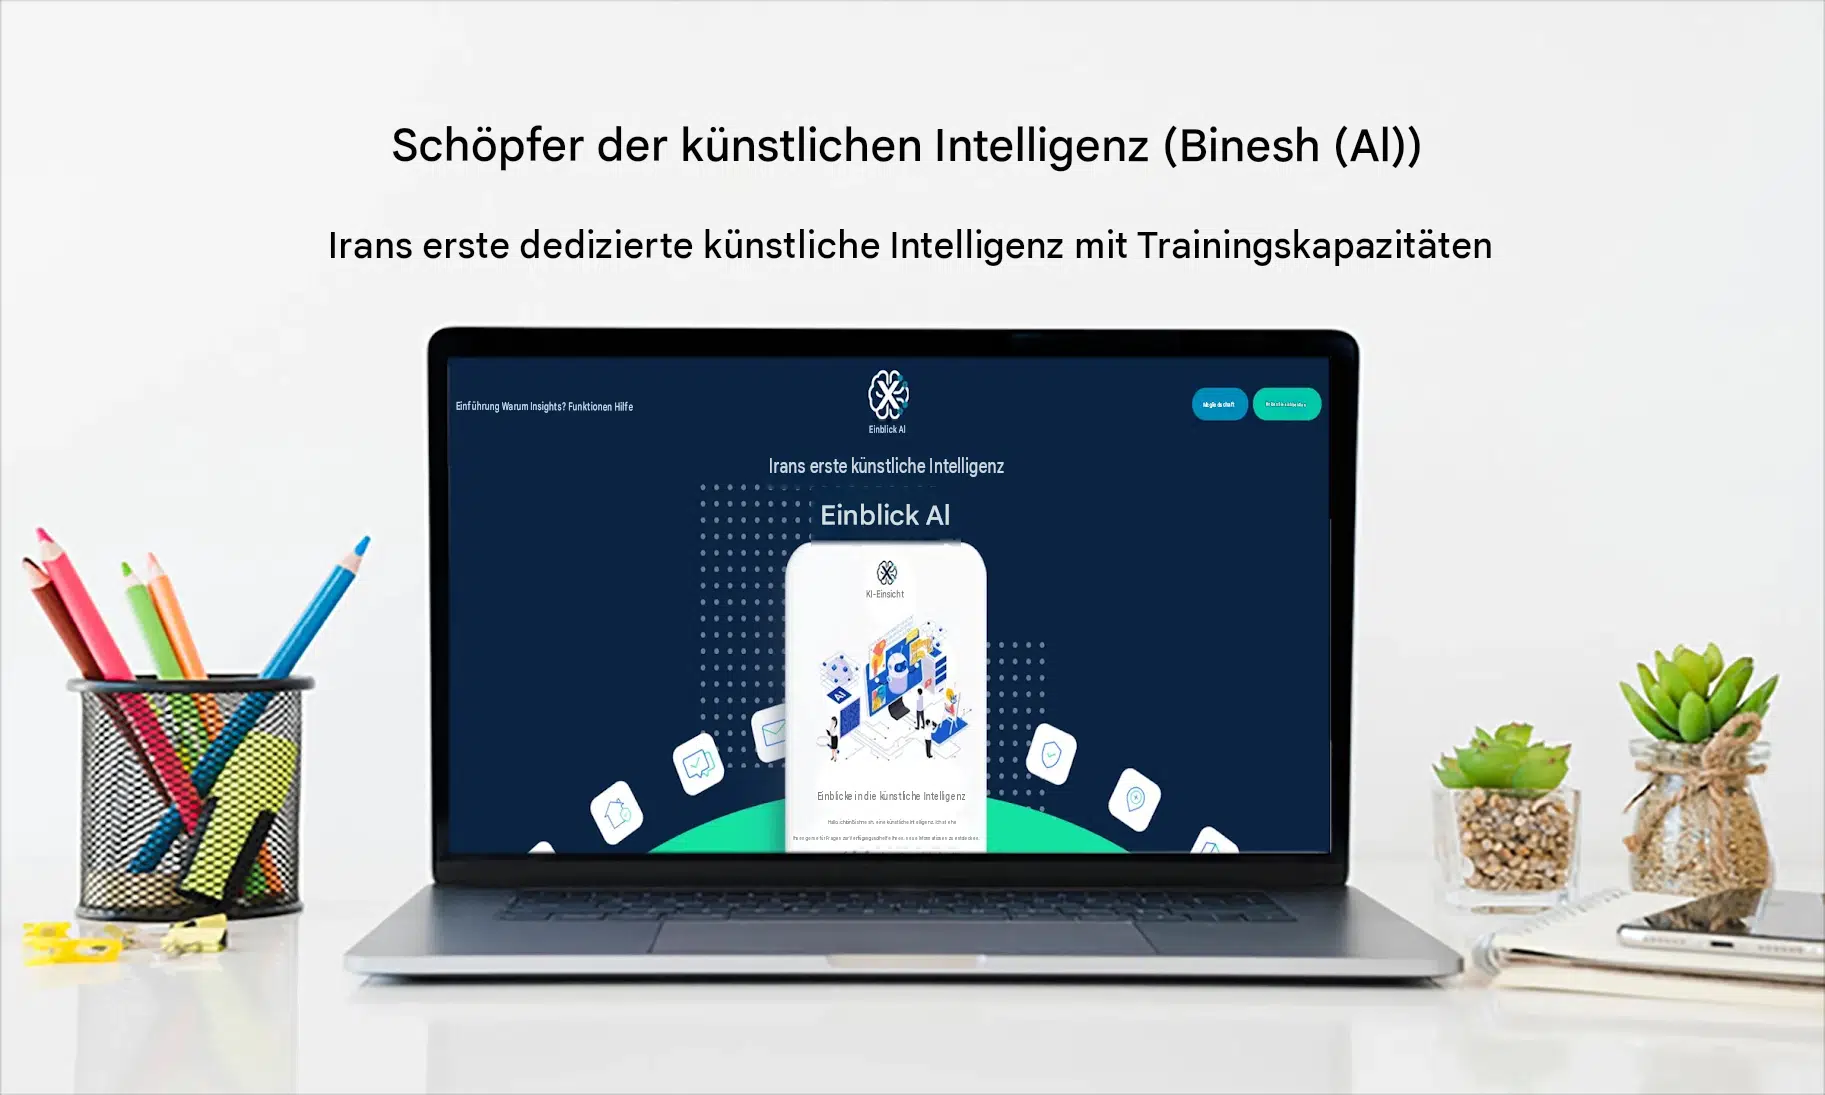
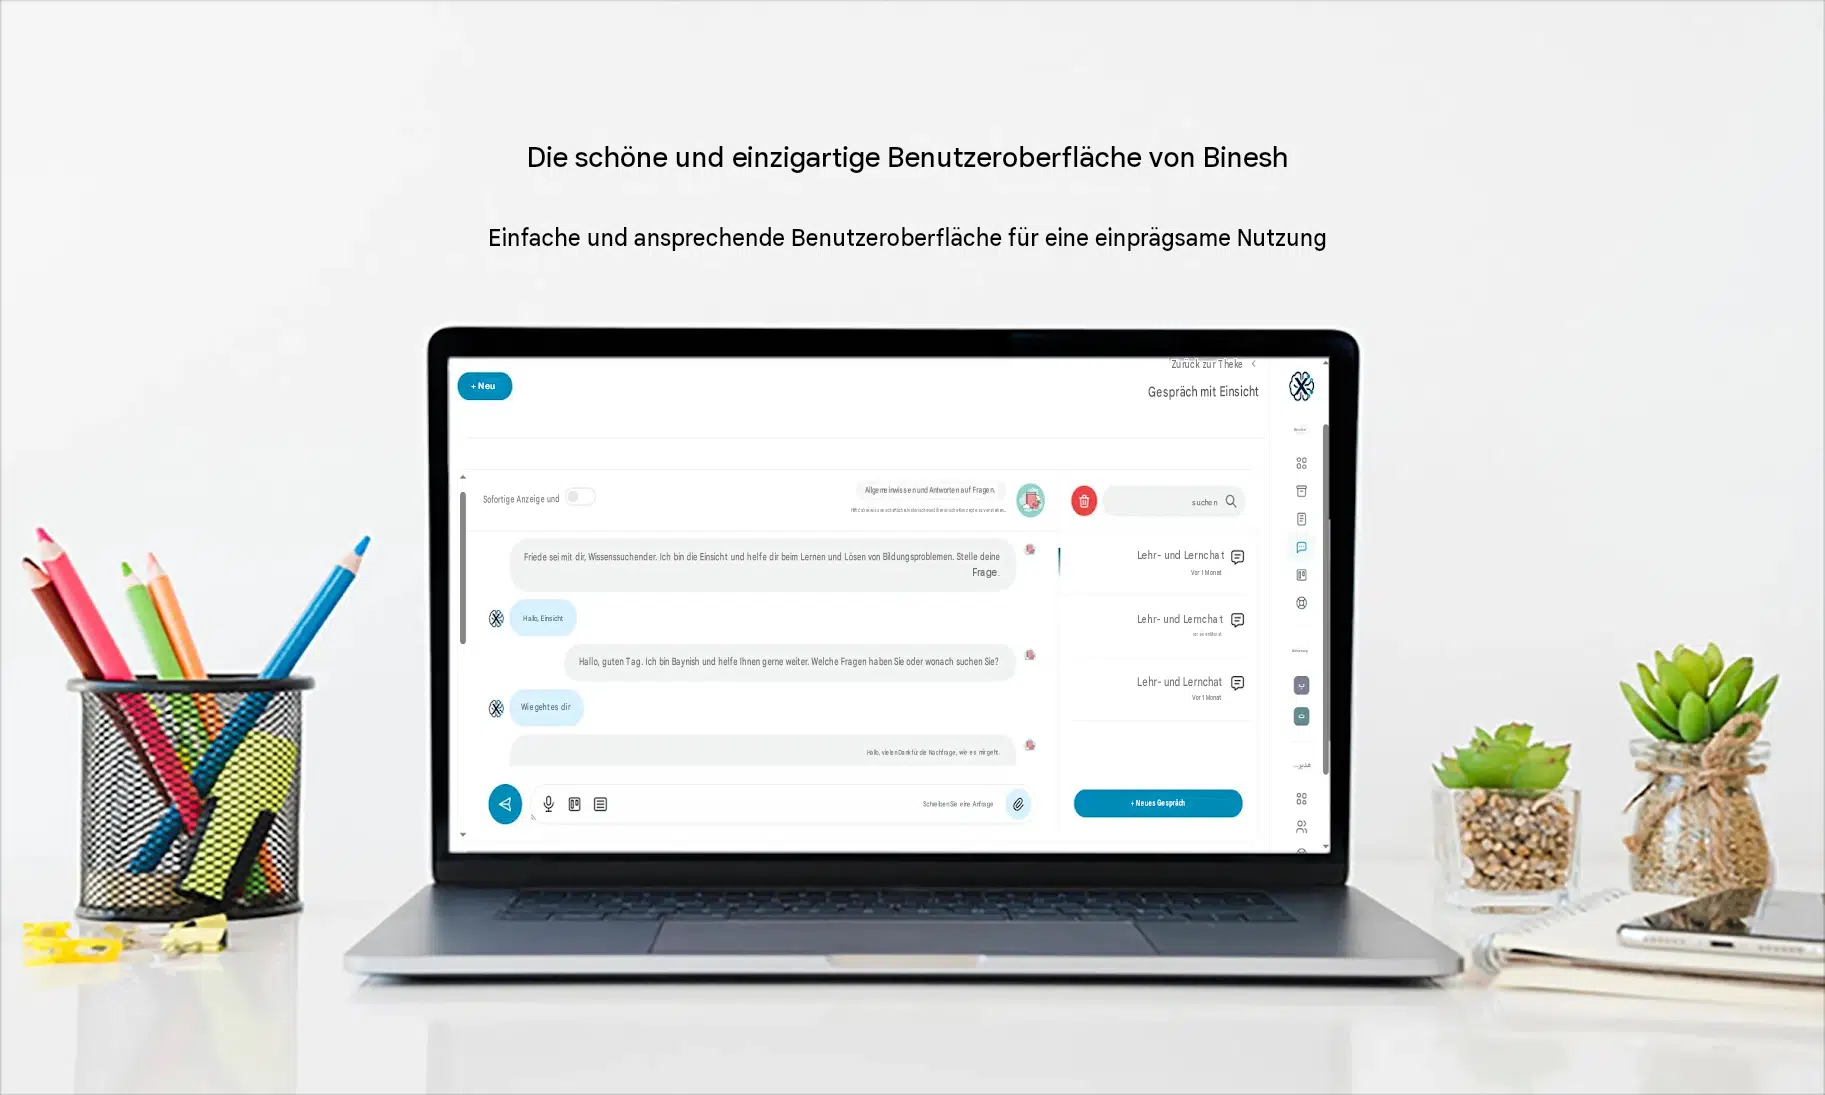
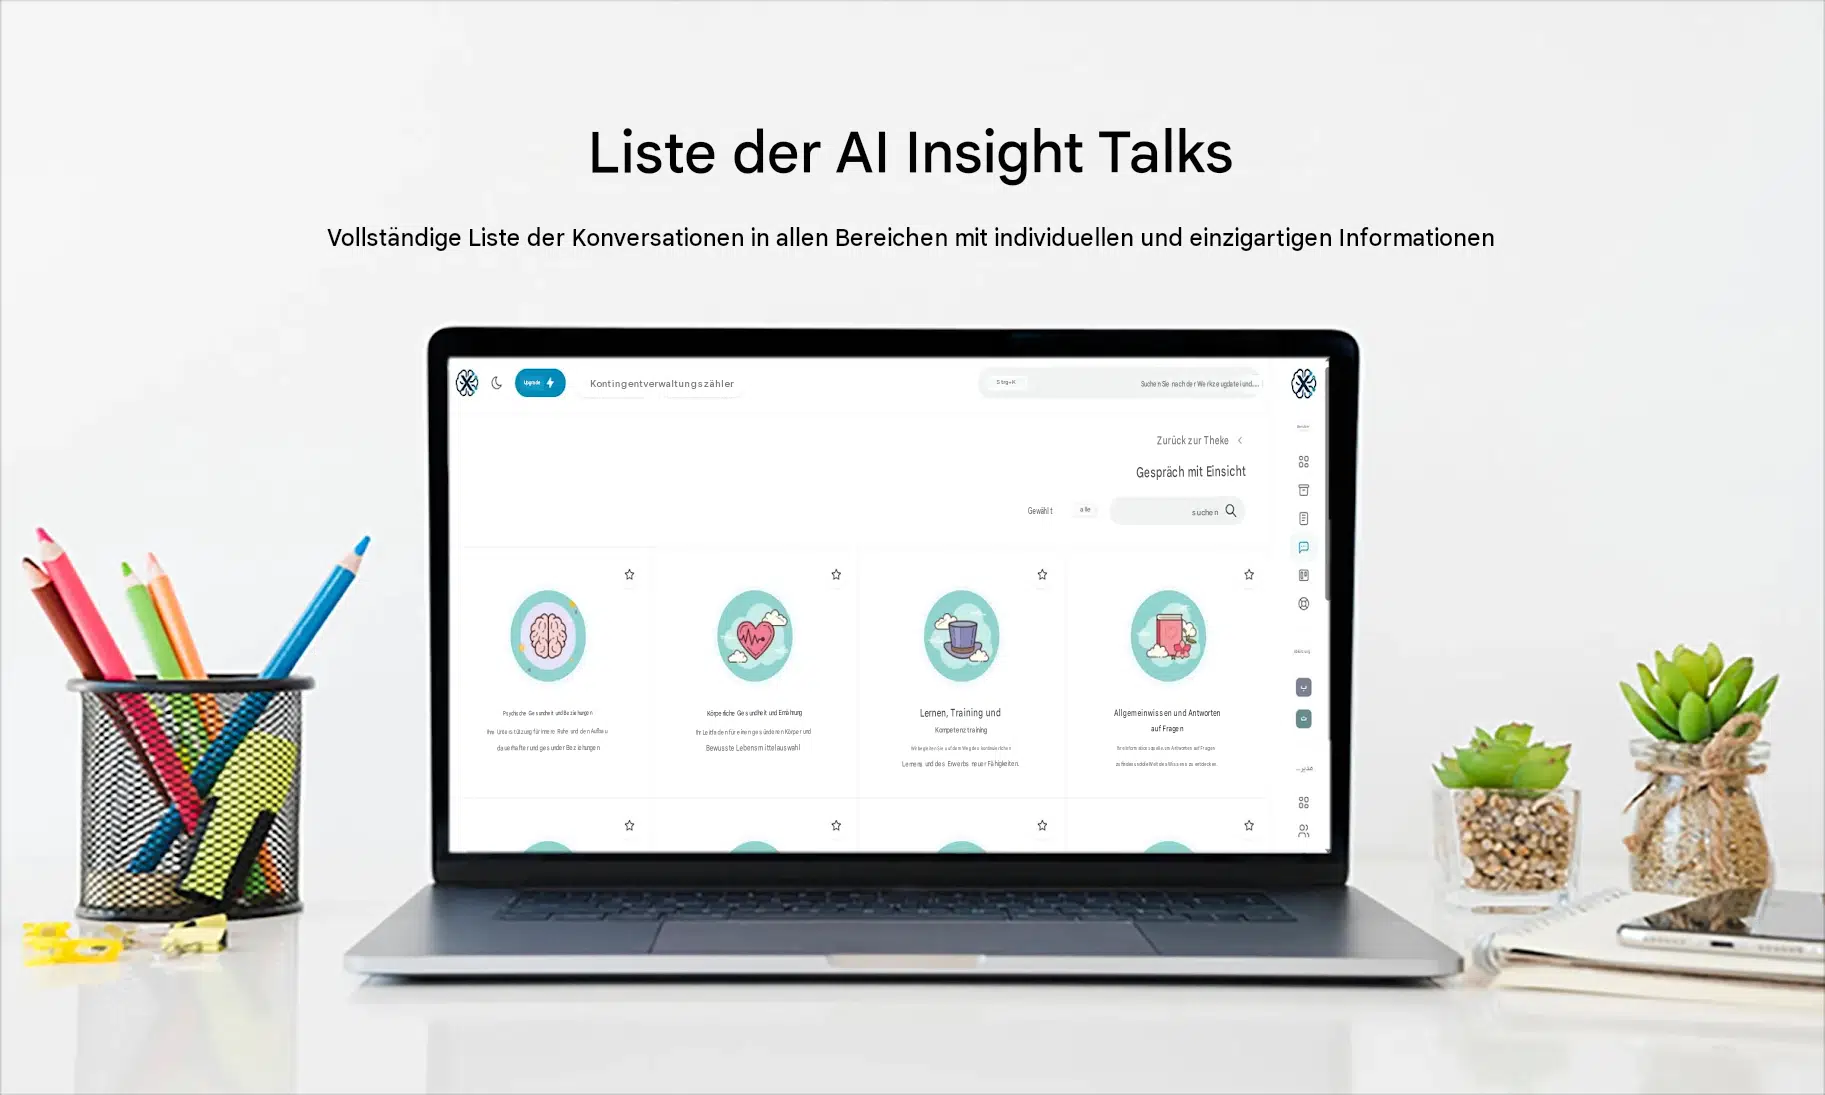
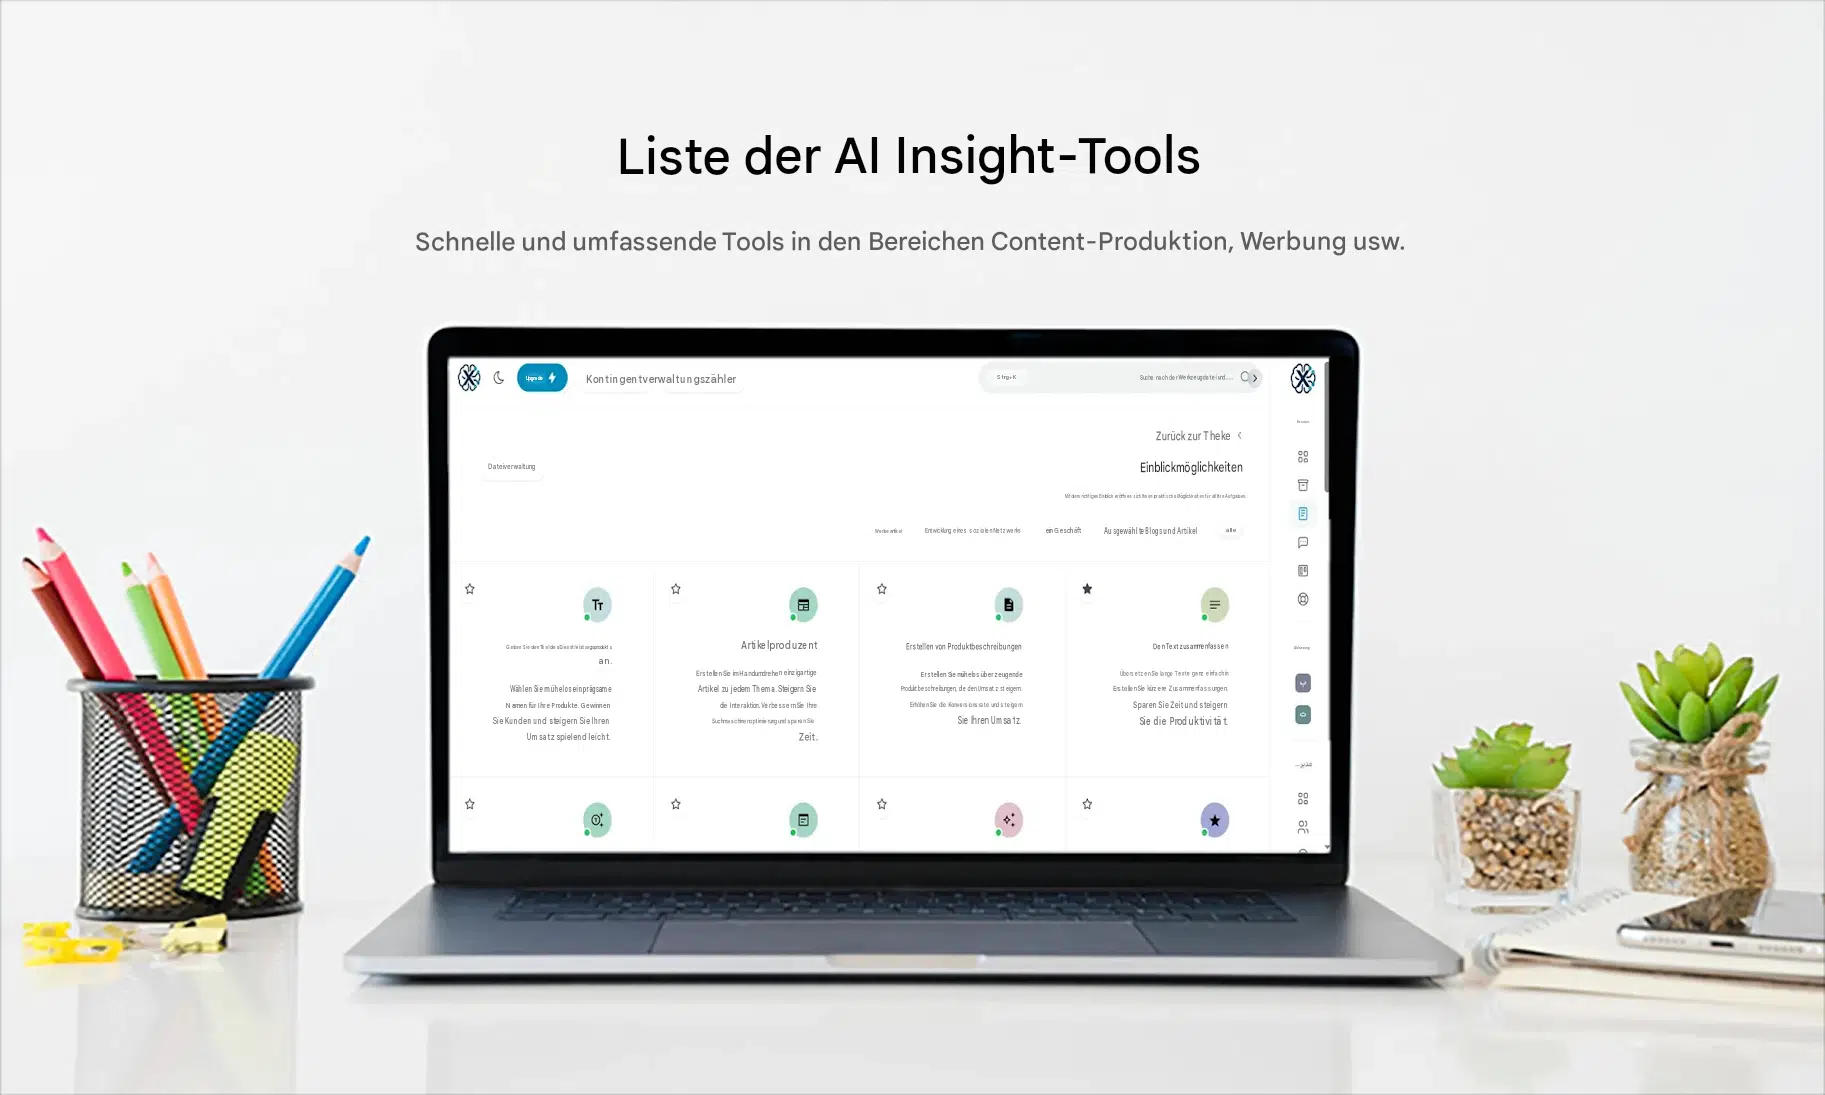
Eine KI entwickeln, die nicht nur antwortet — sondern lernt, sich anpasst und mit Ihren Geschäftsdaten evolviert.
Kurzer Auszug (für Archiv / Karten)
Binesh AI ist ein proprietäres LLM-Framework mit Fine-Tuning, RAG-Pipelines und modularer Intelligenz. Entwickelt für Organisationen, die adaptive, datengetriebene KI verlangen — keine statischen Prompt-Wrapper.
Einführung — Die Engineering-Herausforderung
Die meisten „KI-Lösungen” auf dem Markt sind heute dünne Wrapper um eine öffentliche API. Sie lernen nicht. Sie passen sich nicht an. Sie integrieren keine proprietäre Geschäftslogik. Und sie kollabieren in dem Moment, in dem sich das zugrunde liegende Modell ändert.
Binesh AI wurde entwickelt, um ein anderes Problem zu lösen:
Wie konstruieren wir ein KI-System, das auf das private Wissen einer Organisation feinabgestimmt werden kann, durch intelligente Agenten orchestriert wird und sich über Zeit weiterentwickelt — ohne von einem einzigen Modellanbieter abhängig zu sein?
Dieses Projekt repräsentiert einen vollständigen architektonischen Wandel von „KI als Feature” zu „KI als anpassungsfähiges Unternehmens-Asset”.
Architektur-Überblick
Binesh AI basiert auf vier fundamentalen Ebenen:
┌─────────────────────────────────────────────────────┐
│  1. INTELLIGENTE AGENTEN-EBENE (LangGraph-Orchestrierung)│
├─────────────────────────────────────────────────────┤
│  2. RETRIEVAL-AUGMENTED GENERATION (RAG-Pipeline)   │
├─────────────────────────────────────────────────────┤
│  3. FINE-TUNING & ANPASSUNGS-EBENE                  │
├─────────────────────────────────────────────────────┤
│  4. MODULARE KI-ANWENDUNGEN (Sentiment, Prognose)   │
└─────────────────────────────────────────────────────┘
Detaillierter Leistungsumfang
1. Multi-Agenten-Orchestrierung mit LangGraph
Engineering spezialisierter Agenten-Teams — Retriever-, Reasoner-, Tool-Caller- und Validator-Agenten mit strikt definierten Rollen und Grenzen
Zustandsbehaftete Graph-Orchestrierung — jeder Schritt in der Reasoning-Kette ist definiert, protokolliert und reproduzierbar
Deterministische Task-Ausführung — gleiche Eingabe und Kontext produzieren gleiche Ausgabe, was Audit und Compliance ermöglicht
Rollen-Isolation — kein Agent führt die Funktion eines anderen aus; kein Agent erfindet Tools oder Parameter
Human-in-the-Loop-Gates — Genehmigungsknoten für risikoreiche oder irreversible Operationen
Versioniertes Agenten-Design — Agenten unabhängig bereitgestellt und versioniert, was sichere Evolution ermöglicht
2. Enterprise Hybrid RAG (Retrieval-Augmented Generation)
Semantisches Boundary-Chunking — Dokumente entlang Bedeutungsgrenzen aufgeteilt, nicht willkürlicher Token-Anzahl, was Kontextintegrität bewahrt
Hybride Sucharchitektur — Dense-Vektor-Retrieval kombiniert mit BM25-lexikalischer Suche für sowohl semantische als auch Exact-Match-Präzision
Reciprocal Rank Fusion — rangbasierte Zusammenführung heterogener Retrieval-Signale ohne willkürliche Gewichtung
Cross-Encoder-Re-Ranking — gemeinsame Query-Document-Verarbeitung zur Rauschfilterung, bevor es das Modell erreicht
Vektor-Store-Architektur — pgvector oder Milvus, innerhalb Ihrer Infrastruktur bereitgestellt, mit vollständiger Metadaten-Filterung
Retrieval-Observability — jede Retrieval-, Ranking- und Re-Ranking-Entscheidung wird protokolliert und ist inspizierbar
3. On-Premise & Souveräne Inferenz
Open-Weights-Modell-Bereitstellung — Llama-3, Mistral, Qwen und gleichwertige Modelle via vLLM bereitgestellt
Air-Gapped-Betrieb — vollständig funktionale Bereitstellung mit null externer Netzwerkabhängigkeit
Europäische Datenresidenz — alle Inferenz-, Embedding- und Retrieval-Vorgänge innerhalb Ihrer Infrastruktur ausgeführt
Anbieterunabhängige Architektur — kein Vendor Lock-in; Modelle können ohne Re-Architektur ausgetauscht werden
Quantisierungsstrategie — Q4_K_M und gleichwertige Techniken bewahren 95–98 % der Vollpräzisionsqualität bei einem Bruchteil der Hardwarekosten
Hardware-Dimensionierungs-Beratung — VRAM-, GPU- und Durchsatz-Planung passend zu Ihrer Workload
4. API- & Tool-Calling mit Sicherheitsgrenzen
Natürliche Sprache zu strukturierter Aktion — sichere Übersetzung von Absicht in parametrisierte Datenbankabfragen, ERP-Lookups und Drittanbieter-API-Mutationen
Whitelisted Tool-Schemata — das Modell wählt aus einem definierten Aktionssatz, erfindet ihn niemals
SQL-Sicherheitsvalidierung — SELECT-Only-Erzwingung, LIMIT-Injektion, Statement-Timeout und Read-Only-Ausführungs-Sandboxing
Berechtigungsbewusste Ausführung — Zeilen- und Spaltenebenen-Zugriffskontrolle auf jede generierte Abfrage angewendet
Menschliche Genehmigungs-Gates — Schreiboperationen erfordern explizite menschliche Bestätigung vor Ausführung
Vollständiger Audit-Trail — jede generierte Abfrage, jede ausgeführte Aktion, jedes Ergebnis — mit Akteur, Zeitstempel und Kontext aufgezeichnet
5. Validierung, Guardrails & Halluzinations-Minderung
Dedizierter Validator-Agent — prüft generierte Ausgabe gegen abgerufenen Kontext vor der Auslieferung
Unsupported-Claim-Erkennung — markiert Antworten, die nicht in abgerufenen Belegen geerdet sind
Domänen-Richtlinien-Erzwingung — Compliance-, Ton-, Format- und regulatorische Einschränkungen auf Validierungsebene erzwungen
Ablehnungs- und Retry-Logik — ungültige Ausgaben werden zu einem vorherigen Knoten zurückgeführt, statt ausgeliefert
Konfidenz-Signalisierung — das System zeigt an, wenn es nicht zuverlässig antworten kann, statt zu raten
Kontinuierliche Evaluation — automatisierte Test-Suiten messen Halluzinationsrate, Retrieval-Präzision und Task-Erfolg
6. Bereitstellung, Observability & Operative Übergabe
Containerisierte Bereitstellung (Docker) mit reproduzierbaren Builds
Strukturiertes Logging und Metriken — jede Agenten-Entscheidung, jedes Retrieval und jede Validierung ist beobachtbar
Vollständige Architektur-Dokumentation — Agenten-Graphen, Retrieval-Pipelines, Tool-Schemata und Deployment-Runbooks
Entwickler-Onboarding — interne Teams in die Lage versetzen, Agenten zu erweitern und Tools hinzuzufügen
Wissenstransfer-Sessions — die Organisation besitzt das KI-System, nicht der Anbieter
Technologie-Stack
| Ebene | Technologie |
|---|---|
| Sprache | Python 3.11+ — der Standard für Produktions-KI-Engineering |
| Agenten-Orchestrierung | LangGraph — zustandsbehaftete, deterministische Multi-Agenten-Graphen |
| KI-Framework | LangChain — Tool-Integration, Retrieval und Chain-Komposition |
| API-Ebene | FastAPI — Hochleistungs-, async-native Service-Ebene |
| Vektor-Store | pgvector / Milvus — selbst gehostet, metadaten-gefiltertes Retrieval |
| Inferenz-Server | vLLM — Hochdurchsatz-, air-gap-fähiges LLM-Serving |
| Modelle | Llama-3, Mistral, Qwen (Open-Weights, kommerziell sichere Lizenzen) |
| Embeddings | Lokale Embedding-Modelle — keine externe API-Abhängigkeit |
| Containerisierung | Docker — reproduzierbar, isoliert, umgebungsunabhängig |
| Observability | Strukturiertes Logging, Retrieval-Tracing, Validierungs-Metriken |
| Bereitstellung | Self-Hosted / Air-Gapped / EU-residente Infrastruktur |
Quantitative Geschäftsauswirkung / Verifizierte KPIs
Die folgenden Metriken spiegeln die architektonischen Ergebnisse wider, die über angewandte GenAI-Engagements hinweg angestrebt und validiert wurden:
| KPI | Ziel / Verifiziertes Ergebnis |
|---|---|
| Halluzinationsrate | < 1,5 % auf verifizierter interner Dokumentation |
| Regulatorische Compliance | 100 % DSGVO- und EU-KI-Gesetz-konform durch Architektur |
| Vendor Lock-in | Null — modell-agnostisches, anbieterunabhängiges Design |
| Datensouveränität | 100 % On-Premise- oder EU-residente Inferenzfähigkeit |
| Retrieval-Präzision | Hybride Suche + Re-Ranking deutlich übertreffend naive Vektorsuche |
| Auditierbarkeit | 100 % der Agenten-Entscheidungen, Retrievals und Validierungen protokolliert |
| Tool-Ausführungs-Sicherheit | Whitelisted Schemata, SELECT-Only-Erzwingung, menschliche Genehmigungs-Gates |
| Externe Abhängigkeiten | Null erforderlich für Air-Gapped-Betrieb |
| Modell-Qualitätserhaltung | 95–98 % der Vollpräzisionsqualität unter Q4_K_M-Quantisierung |
Diese Zahlen sind in Produktions-KI-Engineering-Arbeit verankert — einschließlich des Binesh-AI-Frameworks — und repräsentieren die Standards, die auf jede Unternehmensbereitstellung angewendet werden.
Standards & Compliance
Datenschutz & Privatsphäre
DSGVO-Konformität durch Architektur — Datenminimierung, Zweckbindung und Rechtsgrundlage auf jeder Ebene erzwungen
EU-Datenresidenz — Inferenz, Embedding und Retrieval innerhalb europäischer Infrastruktur ausgeführt
Keine externe Datenübertragung — Air-Gapped-Bereitstellung eliminiert Drittanbieter-Exposition vollständig
Recht auf Löschung und Datenportabilität — technisch durchsetzbar durch strukturierte Lösch- und Export-Pipelines
Datenverarbeitungsverträge (DPA) — verfügbar für alle Engagements mit personenbezogenen Daten
EU-KI-Gesetz-Ausrichtung
Technische Dokumentation — Modell-Registry, Versionierung und Konfigurationsaufzeichnungen
Risikomanagementsystem — Validator-Agent und Genehmigungs-Gates als architektonische Kontrollen
Menschliche Aufsicht — explizite Human-in-the-Loop-Knoten für risikoreiche Operationen
Transparenz — jede Antwort auf ihre abgerufenen Belege nachverfolgbar
Aufzeichnungspflicht — unveränderliche Logs von Abfragen, Kontexten und Antworten
Genauigkeit und Robustheit — RAG-Grounding und Validierung als Systemeigenschaften
Sicherheitsarchitektur
Air-Gapped-Betrieb — keine externe Angriffsfläche von der KI-Ebene
SQL-Sicherheits-Erzwingung — SELECT-Only, LIMIT-Injektion, Statement-Timeout, Read-Only-Sandboxing
Berechtigungsbewusste Ausführung — Zeilen- und Spaltenebenen-Zugriffskontrolle auf alle generierten Abfragen
Whitelisted Tool-Schemata — das Modell kann keine undefinierten Aktionen aufrufen
Unveränderliche Audit-Protokollierung — manipulationssichere Aufzeichnungen jeder KI-Interaktion
Architekturstandards
Deterministische Orchestrierung — gleiche Eingabe und Kontext produzieren gleiche Ausgabe
Modell-agnostisches Design — kein Vendor Lock-in, keine Anbieterabhängigkeit
Clean-Architecture-Schichtung — Domänenlogik isoliert von Framework und Infrastruktur
API-First-Verträge — versionierte, dokumentierte, rückwärtskompatible Schnittstellen
Kontinuierliche Evaluation — automatisierte Qualitäts-Gates bei jedem Release
Engagement- & Kollaborationsmodell
| Modell | Beschreibung | Ideal für |
|---|---|---|
| Projekt-basierter KI-System-Build | Vollständige Architektur und Lieferung — Agenten-Graphen, RAG-Pipeline, On-Premise-Inferenz und Produktionsübergabe | Organisationen, die ihr erstes Produktions-KI-System bereitstellen oder einen API-basierten Prototyp ersetzen |
| Architektur-Audit & Roadmap | Tiefenprüfung bestehender KI-Systeme mit priorisierter Remediation- und Souveränitäts-Roadmap | Unternehmen mit bestehender KI-Initiative, die architektonische Strenge erfordern |
| Dedizierter Engineering-Sprint | Fokussiertes Engagement für eine spezifische Fähigkeit — RAG-Pipeline, Agenten-Orchestrierung, On-Premise-Inferenz oder Tool-Calling-Sicherheit | Teams, die gezielte tiefe Expertise für einen definierten Umfang benötigen |
| Architektur-Retainer | Laufende Beratung, Evaluation, Skalierungsstrategie und Evolutionsplanung für bereitgestellte KI-Systeme | Organisationen, die KI in Produktion betreiben und senior-Aufsicht benötigen |
Kollaborationsprinzipien
Direkter Zugang zum Architekten — keine Account Manager, keine Relay-Kommunikation
Strukturierte Discovery — jedes Engagement beginnt mit einer dokumentierten Problem- und Erfolgsdefinition
Evidenzbasierte Lieferung — messbare KPIs vor Implementierungsbeginn definiert
Wissenstransfer als Deliverable — die Organisation besitzt das KI-System, nicht der Anbieter
Souveränität standardmäßig — Architekturentscheidungen für regulatorische Langlebigkeit, nicht Bequemlichkeit
📩 Kontakt & nächster Schritt
Architektieren Sie ein generatives KI-System, das präzise, auditierbar und souverän sein muss?
Beginnen wir mit einer strukturierten architektonischen Beratung — Problemdefinition, Retrieval-Design und eine vorgeschlagene Agenten-Architektur-Roadmap.