


جداسازی منطق کسبوکار سازمانی: معماری بکاند ERP ابری با Clean Architecture
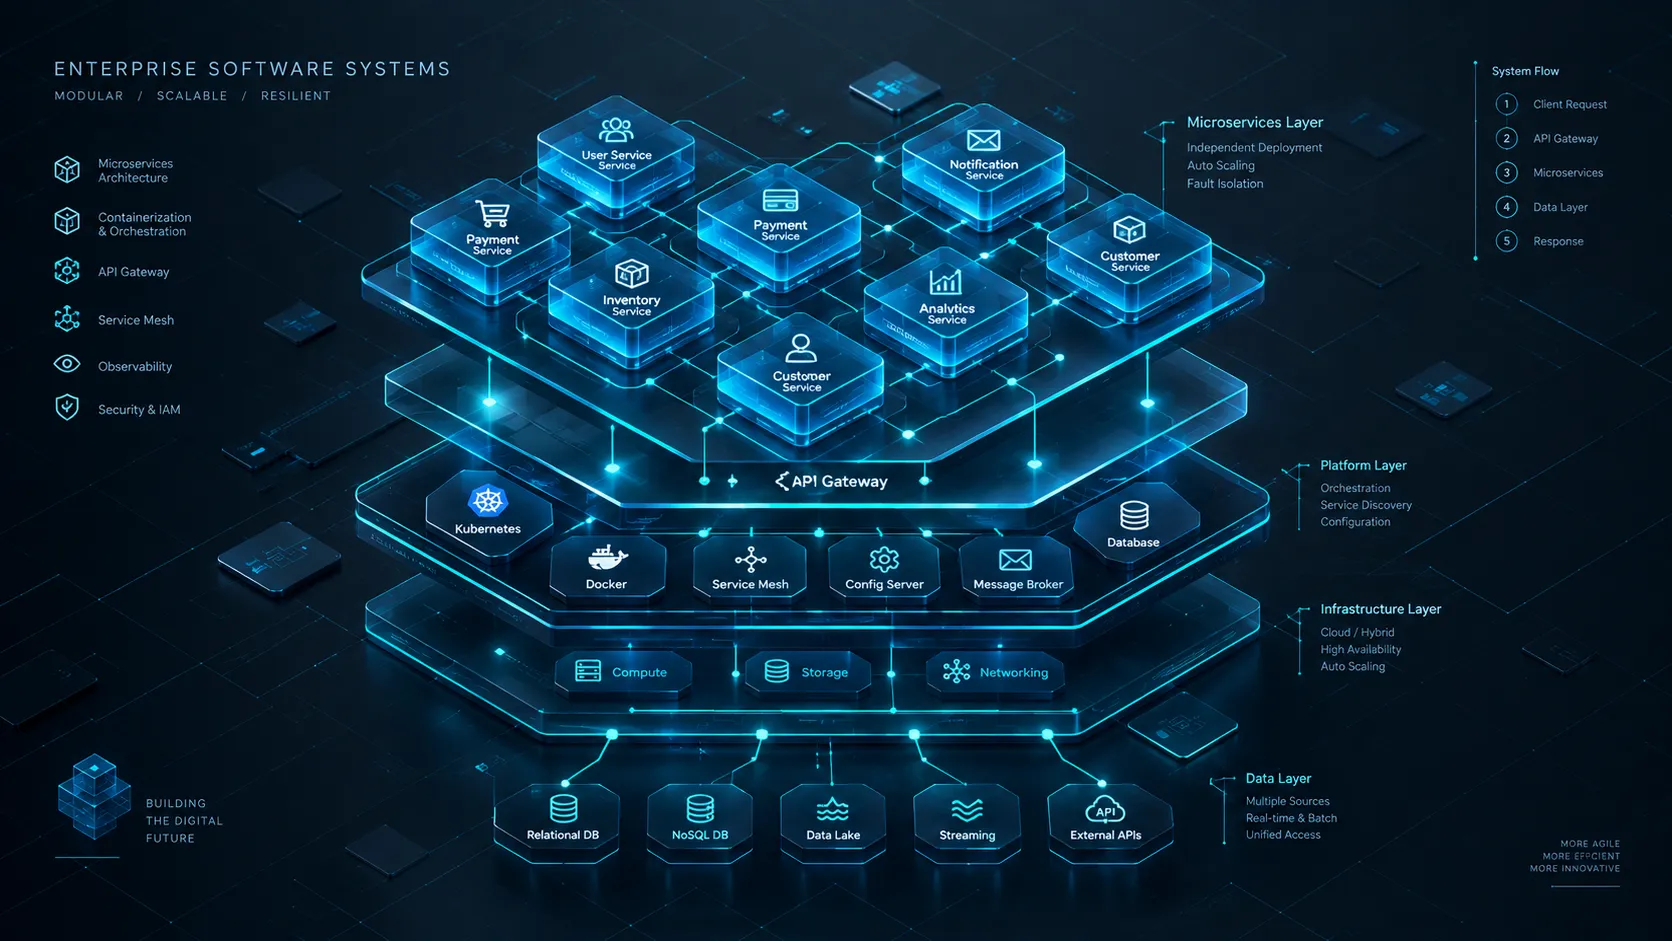
سیستمهای برنامهریزی منابع سازمانی (ERP) در مرکز واقعیت عملیاتی هر سازمان بزرگ قرار دارند. آنها تراکنشهای مالی را پردازش میکنند، موجودی فیزیکی را مدیریت میکنند، زنجیرههای تأمین را هماهنگ میکنند و انطباق را اعمال میکنند. آنها طبق تعریف حیاتی هستند.
با این حال، اکثر سیستمهای ERP پارادوکسهای معماری هستند:
آنها باید تکامل یابند — قوانین کسبوکار دائماً تغییر میکنند
آنها باید پایدار بمانند — توقف واقعاً پول هزینه دارد
آنها باید مقیاسپذیر باشند — حجم تراکنشها بیوقفه رشد میکند
آنها باید قابل حسابرسی باشند — رگولاتورها و حسابرسان ردیابی را میطلبند
پاسخ سنتی، معماریهای مونولیتیک با ماژولهای محکم جفتشده بوده است. این کار میکند — تا زمانی که نمیکند. یک تغییر در منطق صورتحساب، گزارشدهی موجودی را میشکند. یک بهروزرسانی اسکیمای پایگاه داده، دفتر کل را بیثبات میکند. یک ویژگی جدید، بدهی فنی معرفی میکند که برای سالها انباشته میشود.
این مقاله رویکردی متفاوت را بررسی میکند:
معماری بکاندهای ERP با مرزهای دقیق دامنه، اصول Clean Architecture و طراحی پایگاه دادهای که برای پردازش تراکنشهای پرهمزمانی مهندسی شده است.
هدف، ظرافت نظری نیست. هدف، قابلیت عملیاتی در مقیاس است — سیستمی که میتواند بدون شکستن تکامل یابد و تحت بار بدون مصالحه در صحت، عمل کند.
بخش ۱ — چرا Clean Architecture برای ERP غیرقابل مذاکره است
Clean Architecture، همانطور که توسط رابرت سی. مارتین بیان شده، یک اصل بنیادی را تثبیت میکند:
وابستگیها به سمت داخل اشاره میکنند. دامنه هیچ چیز درباره زیرساخت نمیداند.
برای سیستمهای ERP، این یک خلوص دانشگاهی نیست — یک الزام بقا است.
ساختار لایهای
┌─────────────────────────────────────────────────────────────────┐ │ لایه ارائه (Presentation) │ │ (کنترلرهای API، GraphQL، UI) │ ├─────────────────────────────────────────────────────────────────┤ │ لایه اپلیکیشن (Application) │ │ (Use Caseها، هندلرهای CQRS، DTOها، اعتبارسنجی) │ ├─────────────────────────────────────────────────────────────────┤ │ لایه دامنه (Domain) │ │ (Entityها، Value Objectها، سرویسهای دامنه، رویدادها) │ │ — بدون وابستگی خارجی — │ ├─────────────────────────────────────────────────────────────────┤ │ لایه زیرساخت (Infrastructure) │ │ (Persistence، APIهای خارجی، Messaging، Cache) │ └─────────────────────────────────────────────────────────────────┘
جهت وابستگی دقیقاً به سمت داخل است. لایه دامنه، واسطها را تعریف میکند؛ زیرساخت آنها را پیادهسازی میکند.
چرا این برای ERP به طور خاص مهم است
| نگرانی | ERP مونولیتیک | ERP با Clean Architecture |
|---|---|---|
| تغییر قوانین کسبوکار | سرایت در کل کدبیس | محدود به لایه دامنه |
| مهاجرت پایگاه داده | نیازمند دست زدن به منطق کسبوکار | تنها تعویض زیرساخت |
| تست | نیازمند راهاندازی استک کامل | منطق دامنه به صورت مجزا قابل تست |
| ارتقاء فریمورک | ریسک بالا، فرابخشی | محدود به لایههای بیرونی |
| اعضای جدید تیم | باید همه چیز را بفهمند | میتوانند لایه به لایه کار کنند |
هزینه تغییر نسبت معکوس با قدرت مرزهای شما دارد.
ساختار راهحل (عینی)
بر اساس پیادهسازیهای آماده تولید ERP با Clean Architecture:
src/
├── Presentation/
│ └── ERP.API # نقاط پایانی Web API
├── CompositionRoot/
│ └── ERP.CompositionRoot # سیمکشی وابستگیها
├── Core/
│ ├── ERP.Domain # Entityها + قراردادها (بدون وابستگی)
│ ├── ERP.Application # Use Caseها، هندلرها، DTOها
│ └── ERP.Shared # پایههای مشترک
└── Infrastructure/
├── ERP.Infrastructure # یکپارچگیهای سرویس خارجی
└── ERP.Persistence # دسترسی به پایگاه دادهقانون کلیدی: پروژه API هرگز مستقیماً به نوعهای زیرساخت ارجاع نمیدهد. تمام سیمکشی در Composition Root اتفاق میافتد.
بخش ۲ — Domain-Driven Design: بافتهای محدود برای ERP
سیستمهای ERP به طور طبیعی به بافتهای محدود (Bounded Contexts) تجزیه میشوند — هر کدام با زبان همهشمول خود، مدل خود و قوانین خود.
۸ دامنه ردیف-۱ ERP
یک سیستم ERP خوب معماریشده، حالت جهانی را به محیطهای اجرایی جداگانه تقسیم میکند:
| دامنه | مسئولیت |
|---|---|
| مالی | دفتر کل، AP/AR، دفتر دوطرفه تغییرناپذیر |
| زنجیره تأمین | موجودی فیزیکی، ردیابی SKU، تأمین |
| درآمد | سفارشهای فروش، نقشهبرداری ارتباط با مشتری |
| سرمایه انسانی | سوابق کارکنان، حقوق و دستمزد، نقشها |
| داراییهای سازمانی | زیرساخت، مدیریت انبار |
| حقوقی | انطباق، گزارشهای حسابرسی (SOC2/SOX) |
| یادگیری | گواهینامهها، انطباق آموزش |
| دادههای اصلی | “رکورد طلایی” — ترجمه شناسه جهانی |
نخ طلایی: ارتباط بین-دامنهای بدون کلید خارجی SQL
سیستمهای ERP سنتی از کلیدهای خارجی در سطح پایگاه داده برای حفظ یکپارچگی ارجاعی بین دامنهها استفاده میکنند. این جفتشدگی محکم در لایه داده ایجاد میکند — مضرترین شکل بدهی فنی در سیستمهای ERP.
جایگزین معماری: نخ طلایی:
رویکرد سنتی: SalesOrder.customer_id → FOREIGN KEY → Customer.id → جفتشدگی تحمیلشده توسط پایگاه داده → دامنهها نمیتوانند مستقل مقیاسپذیر شوند → تغییرات اسکیما در دامنهها منتشر میشوند رویکرد نخ طلایی: SalesOrder.customer_uuid: uuid.UUID (اشارهگر مدیریتشده توسط اپلیکیشن) → بدون FK در سطح پایگاه داده بین دامنهها → هر دامنه جدولهای خود را منحصراً مالک است → دامنهها به صورت افقی و مستقل مقیاس مییابند
منطق مهندسی: کلیدهای خارجی جفتشدگی ضمنی ایجاد میکنند. در یک سیستم پرترافیک، یک حذف گروهی روی جدول والد، بررسیهای محدودیت را در تمام جدولهای ارجاعدهنده فعال میکند — یک فاجعه عملکردی در مقیاس.
وقتی یک مشتری با ۵۰۰,۰۰۰ سفارش حذف میشود، پایگاه داده باید هر مرجع کلید خارجی را تأیید کند. این دلیل است که سیستمهای ERP تولیدی گزارش میدهند که حذفهای گروهی بیش از ۱۲۰ دقیقه و فایلهای موقت ۲۸۰GB طول میکشد.
تراکنشهای توزیعشده: الگوی Saga
بدون تراکنشهای ACID در سطح پایگاه داده بین دامنهها، چگونه سازگاری را حفظ میکنیم؟
Sagaهای زمانی — جریانهای کاری توزیعشده با اقدامات جبرانی:
سناریو: تخصیص سفارش بین زنجیره تأمین و مالی ┌─────────────────────────────────────────────────────────────┐ │ جریان کاری Saga سفارش │ ├─────────────────────────────────────────────────────────────┤ │ ۱. ReserveInventoryActivity (دامنه SCM) │ │ └─ موفقیت → برو به گام ۲ │ │ └─ شکست → جبران، لغو │ │ │ │ ۲. LockLedgerActivity (دامنه مالی) │ │ └─ موفقیت → برو به گام ۳ │ │ └─ شکست → فعالسازی ReverseInventoryActivity │ │ │ │ ۳. ConfirmOrderActivity (دامنه درآمد) │ │ └─ موفقیت → Saga کامل شد │ │ └─ شکست → جبران تمام گامهای قبلی │ └─────────────────────────────────────────────────────────────┘
این الگو سازگاری نهایی را بدون قفلهای فانتوم یا Deadlockهای توزیعشده تضمین میکند.
بخش ۳ — PostgreSQL برای ERP پرهمزمانی: جزئیات مهندسی
PostgreSQL انتخاب پایگاه داده برای اکثر سیستمهای ERP مدرن است. اما پیکربندیهای پیشفرض برای پردازش تراکنشهای پرهمزمانی کافی نیستند.
تله ایندکسگذاری کلید خارجی
این شایعترین نظارت عملکردی در طراحی پایگاه داده ERP است.
واقعیت: PostgreSQL به طور خودکار روی سمت ارجاعشده یک کلید خارجی (کلید اصلی جدول والد) یک ایندکس ایجاد میکند. اما روی سمت ارجاعدهنده (خود ستون کلید خارجی) به طور خودکار ایندکس ایجاد نمیکند:
جدولها: orders (id PRIMARY KEY, customer_id BIGINT, ...) customers (id PRIMARY KEY, ...) PostgreSQL به طور خودکار ایجاد میکند: INDEX ON customers(id) ← از قبل PK است، پس No-Op PostgreSQL ایجاد نمیکند: INDEX ON orders(customer_id) ← مسئولیت شما
پیامد: پرسوجوهایی که روی orders.customer_id فیلتر یا Join میکنند، اسکن کامل جدول انجام میدهند. حذفهای آبشاری و بررسیهای محدودیت کلید خارجی نیز کل جدول را اسکن میکنند.
تأثیر واقعی از یک بار کاری ERP تولیدی:
| معیار | قبل از ایندکسگذاری | بعد از ایندکسگذاری |
|---|---|---|
| زمان حذف گروهی | ۱۲۰+ دقیقه | ~۶۲ دقیقه |
| تولید فایل موقت | ۲۸۰ GB/روز | ۱۹۲.۹ GB/روز |
| جهشهای Read IOPS | ۱۰-۱۵ بار/روز | ۵-۷ بار/روز |
اسکنهای ایندکس روی account_payment | — | ۹۰۶,۰۰۰+ در پنجره مشاهده |
راهحل: هر ستون کلید خارجی را حسابرسی کنید. اگر در WHERE، JOIN یا عملیات آبشاری استفاده میشود، آن را ایندکس کنید.
استراتژی ایندکسگذاری برای بارهای کاری ERP
پایگاههای داده ERP الگوهای دسترسی متمایزی دارند:
| الگوی پرسوجو | استراتژی ایندکس |
|---|---|
| گزارشهای بازه زمانی (دفتر کل، تراکنشها) | ایندکس ترکیبی روی (entity_id, transaction_date) |
| فیلتر مبتنی بر وضعیت (سفارشهای در انتظار، موجودی فعال) | ایندکسهای جزئی روی ستونهای وضعیت |
| جستجوهای نقطهای (بر اساس ID، بر اساس کد) | Primary Key یا Unique Index |
| Joinهای بین-موجودیتی | ستونهای کلید خارجی ایندکسشده |
| گزارشهای تجمیعی | ایندکسهای Covering در صورت امکان |
بینش حیاتی: ایندکسها رایگان نیستند. هر ایندکس سربار نوشتن اضافه میکند. برای سیستمهای ERP پرتراکنش، نسبت هزینه/فایده باید اندازهگیری شود، نه فرض.
پایش و نگهداری
پایگاههای داده پرتراکنش، Bloat را انباشته میکنند — Tupleهای مرده از بهروزرسانیها و حذفها.
نگهداری ضروری برای PostgreSQL ERP:
-- VACUUM و ANALYZE منظم VACUUM ANALYZE orders; VACUUM ANALYZE gl_entries; -- پایش Bloat SELECT schemaname, tablename, pg_size_pretty(pg_total_relation_size(schemaname||'.'||tablename)) as total_size, n_dead_tup FROM pg_stat_user_tables ORDER BY n_dead_tup DESC; -- شناسایی ایندکسهای بدون استفاده SELECT indexrelname, idx_scan, idx_tup_read FROM pg_stat_user_indexes WHERE idx_scan = 0 AND indexrelname NOT LIKE '%_pkey';
فلسفه نگهداری: بهینهسازی ایندکس یک فعالیت یکباره نیست. یک مسئولیت عملیاتی مداوم است.
بخش ۴ — CQRS و جداسازی خواندن/نوشتن
سیستمهای ERP الگوهای دسترسی اساساً متناقض دارند:
مسیر نوشتن: به شدت نرمالشده، از نظر تراکنشی صحیح، منطبق با ACID
مسیر خواندن: Denormalized، تجمیعشده، بهینهشده برای گزارشدهی
CQRS (جداسازی مسئولیت پرسوجو/فرمان) این را حل میکند.
الگوی CQRS در ERP
┌─────────────────────────────────────────────────────────────────┐
│ سمت فرمان (Command) │
│ (عملیات نوشتن: CreateOrder، PostJournalEntry، AdjustStock) │
│ │
│ مدل دامنه → قوانین کسبوکار → Event Store / پایگاه داده نوشتن │
│ │
│ ویژگیها: │
│ - اعتبارسنجی کامل منطق دامنه │
│ - سازگاری تراکنشی │
│ - اسکیمای نرمالشده │
│ - انتشار رویداد برای مصرفکنندگان پاییندست │
└─────────────────────────────────────────────────────────────────┘
│
│ رویدادهای دامنه
▼
┌─────────────────────────────────────────────────────────────────┐
│ سمت پرسوجو (Query) │
│ (عملیات خواندن: گزارشها، داشبوردها، جستجو) │
│ │
│ مدلهای خواندن → Viewهای بهینهشده → Query DB / Cache │
│ │
│ ویژگیها: │
│ - Denormalized برای خواندن سریع │
│ - سازگار در نهایت │
│ - بهینهشده برای الگوهای پرسوجوی خاص │
│ - میتواند از موتورهای ذخیرهسازی مختلف استفاده کند │
└─────────────────────────────────────────────────────────────────┘چرا این برای ERP مهم است
گزارشهای مالی نیازمند تجمیع میلیونها تراکنش هستند. اجرای این پرسوجوها علیه پایگاه داده تراکنشی، رقابت قفل (Lock Contention) ایجاد میکند که تراکنشهای جدید را مسدود میکند.
CQRS فراهم میکند:
جداسازی: پرسوجوهای گزارشدهی هرگز نوشتنهای تراکنشی را مسدود نمیکنند
بهینهسازی: هر سمت از مدل داده مناسب برای بار کاری خود استفاده میکند
مقیاسپذیری: Replicaهای خواندن میتوانند به طور مستقل مقیاس شوند
بخش ۵ — جلوگیری از بدهی فنی در سیستمهای پرهمزمانی
بدهی فنی در سیستمهای ERP به طور منحصربهفردی خطرناک است زیرا در هر تراکنش، هر گزارش و هر نقطه یکپارچگی انباشته میشود.
الگوی ضد-Edge Case
شایعترین منبع بدهی فنی ERP: طراحی برای هر استثنای ممکن.
«کمتر از ۵٪ سناریوها بیش از ۵۰٪ پیچیدگی طراحی را هدایت میکردند. اکثر تراکنشها هرگز آن مسیرها را لمس نمیکردند. اما هر تراکنش وزن آن طراحی را حمل میکرد.»
راهحل: برای مسیر رایج طراحی کنید. سناریوهای نادر را جدا کنید. اجازه دهید اقلیت نیازمند مداخله انسانی باشد.
رویکرد اشتباه: رویکرد صحیح:
───────────────────────────── ─────────────────────────────
هر تراکنش از اعتبارسنجی مسیر رایج: جریان کاری خودکار
کامل تمام Edge Caseها سادهشده
عبور میکند
سناریوهای نادر: برای بررسی
نتیجه: انسانی علامتگذاری شده
- ۵۰٪ کد ۵٪ تراکنشها را
مدیریت میکند نتیجه:
- هر تراکنش هزینه عملکرد - ۹۵٪ تراکنشها سریع
را میپردازد - Edge Caseها به درستی مدیریت
- پیچیدگی تست منفجر میشود - کدبیس قابل نگهداری
- تغییر خطرناک میشوداصل هسته پاک
برای سیستمهای ERP که با پلتفرمهای خارجی (CRM، تجارت الکترونیک، افزونههای BTP) یکپارچه میشوند:
هسته را پاک نگه دارید. افزونهها را بیرون بسازید. از رویدادها برای ارتباط استفاده کنید.
| اصل | پیادهسازی |
|---|---|
| بدون تغییرات هسته | فقط نقاط افزونه |
| بدون نوشتن مستقیم در هسته | ارتباط با واسطه API |
| یکپارچگی مبتنی بر رویداد | ناهمگام، جفتشده ضعیف |
| مالکیت داده مشخص | سیستم مرجع برای هر دامنه تعریفشده |
این از مشکل “Shadow ERP” جلوگیری میکند — جایی که افزونهها آنقدر محکم جفت میشوند که به طور مؤثر هسته را جایگزین میکنند و کابوسهای ارتقاء ایجاد میکنند.
بخش ۶ — معماری در عمل: جریان درخواست
درک اینکه چگونه یک درخواست از لایههای ERP با Clean Architecture عبور میکند.
جریان پرسوجو (عملیات خواندن)
GET /api/finance/journal-entries?dateFrom=2025-01-01 ۱. کنترلر API درخواست را دریافت میکند └─ GetJournalEntriesQuery میسازد ۲. کنترلر پرسوجو را از طریق MediatR میفرستد └─ IMediator.Send(query) ۳. هندلر اپلیکیشن اجرا میکند: ├─ از IJournalEntryRepository استفاده میکند (واسط از دامنه) ├─ فیلتر و صفحهبندی اعمال میکند ├─ Entityها را به DTO نگاشت میکند └─ Result<PagedResult<JournalEntryDto>> برمیگرداند ۴. کنترلر Result<T> را به پاسخ API تبدیل میکند
جریان فرمان (عملیات نوشتن)
POST /api/finance/journal-entries ۱. کنترلر API درخواست را دریافت میکند └─ CreateJournalEntryCommand میسازد ۲. کنترلر فرمان را از طریق MediatR میفرستد └─ IMediator.Send(command) ۳. هندلر اپلیکیشن اجرا میکند: ├─ محدودیتهای کسبوکار را اعتبارسنجی میکند ├─ Entity دامنه را از طریق JournalEntry.Create(...) میسازد ├─ با Repository + Unit of Work ذخیره میکند └─ Result<JournalEntryDto> برمیگرداند ۴. کنترلر 201 Created صادر میکند
نگرانیهای فرابخشی (خط لوله MediatR)
سیستمهای ERP تولیدی با Clean Architecture، رفتارهای خط لوله را به ترتیب دقیق ثبت میکنند:
۱. LoggingBehavior → ثبت درخواست/پاسخ ۲. PerformanceBehavior → اندازهگیری زمان اجرا ۳. ValidationBehavior → قوانین FluentValidation ۴. CachingBehavior → برای پرسوجوهایی که ICacheableRequest را پیادهسازی میکنند ۵. AuditingBehavior → چه کسی چه کاری، چه زمانی ۶. NotificationBehavior → ارسال رویداد دامنه ۷. RetryBehavior → تابآوری خطای گذرا
چرا ترتیب مهم است: اعتبارسنجی باید قبل از کش اجرا شود (درخواستهای نامعتبر را کش نکنید). حسابرسی باید بعد از اعتبارسنجی اجرا شود (فقط عملیات معتبر را حسابرسی کنید).
بخش ۷ — چه زمانی از این معماری استفاده کنیم (و چه زمانی نه)
از Clean Architecture + DDD برای ERP استفاده کنید وقتی:
✅ قوانین کسبوکار پیچیده هستند و مکرراً تغییر میکنند
✅ چندین تیم روی همان سیستم کار میکنند
✅ سیستم با پلتفرمهای خارجی زیادی یکپارچه میشود
✅ قابلیت نگهداری بلندمدت اولویت است
✅ صحت تراکنشی غیرقابل مذاکره است
✅ دامنه بافتهای محدود واضحی دارد
از آن استفاده نکنید وقتی:
❌ برنامه یک رابط CRUD ساده است
❌ تیم تجربه مدلسازی دامنه ندارد
❌ سرعت به بازار بر ساختار بلندمدت غلبه دارد
❌ دامنه به اندازه کافی پیچیده نیست که لایهها را توجیه کند
Clean Architecture یک سرمایهگذاری است. بازده خود را در قابلیت نگهداری و مقیاسپذیری میپردازد. هزینه آن پیچیدگی اولیه است. سؤال این است که آیا سیستم ERP شما به اندازه کافی زنده میماند که بازده را جمعآوری کند.
نتیجهگیری — ERP به عنوان یک دیسیپلین مهندسی
سیستمهای ERP “نرمافزار کسبوکار” نیستند. آنها سیستمهای توزیعشده با پیامدهای مالی هستند.
تصمیمات معماری که در ابتدا گرفته میشوند — چگونه دامنهها محدود میشوند، دادهها چگونه جریان مییابند، سازگاری چگونه حفظ میشود، ایندکسها چگونه طراحی میشوند — تعیین میکنند که آیا سیستم:
مقیاسپذیر با حجم تراکنش میشود، یا تحت بار فرو میریزد
تکامل با نیازهای کسبوکار مییابد، یا در برابر تغییر مقاومت میکند
صحیح تحت همزمانی میماند، یا به طور خاموش داده را خراب میکند
قابل بهرهبرداری برای سالها باشد، یا بدهی انباشته کند تا جایگزینی تنها گزینه باشد
Clean Architecture، Domain-Driven Design و مهندسی PostgreSQL شعار نیستند. آنها دیسیپلینهایی هستند — هرکدام یک حالت شکست خاص سیستمهای سازمانی را حل میکند.
هدف، معماری کامل نیست. هدف، معماریای است که به کسبوکار امکان میدهد فعالیت، مقیاسپذیری و تکامل یابد — بدون اینکه سیستم به گلوگاه تبدیل شود.
یادداشت نویسنده
این مقاله الگوهای معماری توسعهیافته در هنگام ساخت CoreBiz ERP — یک پلتفرم سازمانی ماژولار برای حسابداری، موجودی و تراکنشهای بین-دپارتمانی — را بازتاب میدهد. برای همکاری در معماری ERP سازمانی، از طریق صفحه تماس با من در ارتباط باشید.